从问题定义到价值函数
一个折扣 MDP 写为 (S,A,P,r,γ,μ0)。P(ds′∣s,a) 是转移概率核,r(s,a) 是条件期望奖励,0≤γ<1。固定策略后,价值函数描述未来回报:
Vπ(s)=Eπ[t=0∑∞γtrt∣s0=s],Qπ(s,a)=E[r0+γVπ(s1)∣s0=s,a0=a].
由全期望公式得到 Vπ(s)=Ea∼π[Qπ(s,a)] 和 Bellman 期望方程 Vπ=TπVπ。最优算子把对策略的期望替换为动作最大化,但最优回溯、策略评估、样本更新是三个不同层次。
三种误差不能混用
| 对象 |
定义 |
要点 |
| 样本 TD error |
δ=r+γVθ(s′)−Vθ(s) |
含有奖励和转移噪声 |
| Bellman residual |
TπVθ−Vθ |
是对后继随机性取期望后的函数 |
| Projected residual |
ΠDTπVθ−Vθ |
先投影到可表示的函数空间 |
一般而言,E[δ2] 不等于 MSBE,因为前者还包含条件方差。MSBE 是 ∥TπVθ−Vθ∥D2;在线性逼近下,MSPBE 是 ∥ΠDTπVθ−Vθ∥D2。权重 D 决定在哪些状态上衡量误差。小训练损失不自动意味着小真实价值误差或更好的策略梯度。
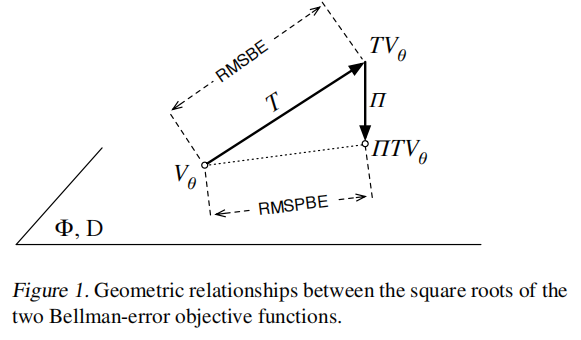
笔记包所附示意图:T 表示 Bellman 算子,Π 表示投影;RMSBE 和 RMSPBE 分别对应两个不同距离。
半梯度、真梯度与双采样
普通 TD 把 bootstrap target 当作常量,只更新当前状态的预测,因此称为半梯度。若直接求 MSBE 梯度,会出现两个条件期望的乘积;用同一个后继样本估计两项通常有偏。无偏残差梯度一般需要给定同一状态动作后的两个独立后继样本,确定性转移等特殊情形除外。
线性 TD 寻找的是投影不动点,不一定是 MSBE 的最小值。GTD2/TDC 引入辅助递推,构造 MSPBE 的梯度相关更新;其收敛结论需要固定策略、线性特征、覆盖、矩条件和步长假设,不能直接移植到任意深度控制算法。
阅读与实验建议
先明确策略、采样分布、投影范数和目标,再比较 loss。小型表格 MDP 可以同时计算真实价值、MSBE、MSPBE 和样本 TD loss,观察它们是否一起下降。原文件 Basic Concept 完整包含于 Bellman Error,此处合并讲解,两个来源均保留。
继续阅读:GTD2/TDC、价值外推、收敛条件。
原笔记中的选读链接